Antwort in Kürze: KI-Suchmaschinen wie ChatGPT, Perplexity und Google AI Overviews zitieren bevorzugt Seiten, die konkrete Zahlen, eigene Erhebungen und nachprüfbare Originaldaten enthalten, weil solche Inhalte für das Sprachmodell als eigenständiger Beleg funktionieren und sich ohne Umformulierung in eine Antwort übernehmen lassen. Generische Erklärtexte ohne Zahlen konkurrieren dagegen mit hunderten austauschbaren Quellen. Wer zitiert werden will, muss deshalb Daten liefern, die es so nirgendwo anders gibt, und sie in kompakten, selbstenthaltenden Absätzen aufbereiten.
Warum zitieren KI-Suchmaschinen bevorzugt Seiten mit eigenen Statistiken?
Antwort-Block: Generative Suchmaschinen wählen Quellen nach ihrem Beitrag zur Antwort aus. Eine konkrete Zahl, ein Messwert oder ein Datenpunkt aus einer eigenen Erhebung ist ein solcher Beitrag, weil er eine Behauptung belegt statt sie nur zu wiederholen. In der GEO-Forschung gehört das Hinzufügen von Statistiken und konkreten Zahlen zu den experimentell untersuchten Optimierungen mit positivem Effekt auf die Sichtbarkeit in generativen Antworten, wie eine Untersuchung von Aggarwal et al. (2024) zeigt.
Drei Mechanismen stehen dahinter:
- Belegfunktion. Das Modell braucht für eine Aussage in der Antwort eine Quelle, die diese Aussage tatsächlich trägt. Eine Seite mit Zahl und Herkunft der Zahl erfüllt das; eine Seite mit "viele Studien zeigen" nicht.
- Einzigartigkeit. Originaldaten existieren nur an einer Stelle im Web. Die Zitation kann nicht auf eine beliebige andere Quelle ausweichen.
- Extrahierbarkeit. Kurze, in sich geschlossene Absätze mit Zahl, Kontext und Quelle lassen sich vom Modell direkt übernehmen, wie Tian et al. (2026) nahelegt.
Wichtig: Diese Maßnahmen sind als experimentell einzustufen. Sie beruhen auf dem Stand der Forschung, nicht auf einer Zitationsgarantie.
Wer wird zu diesem Thema aktuell zitiert?
Antwort-Block: Zu der Frage, warum KI-Suchmaschinen Seiten mit eigenen Statistiken bevorzugen, zitiert ChatGPT derzeit vor allem Forschungs- und Google-Quellen sowie einige Agentur- und Tool-Blogs. Die am häufigsten zitierten Domains sind arxiv.org, developers.google.com, ihp-media.com, internetmarketingagentur.de, geaio.de, ranktracker.com, blog.google und ecin.de (Auswertung der ucited-Zitationsdaten, Stand September 2026).
Auffällig ist, dass wissenschaftliche Primärquellen (arxiv.org, doi.org) und Google-Dokumentation stark vertreten sind: genau die Quellentypen, die Originaldaten oder verbindliche Aussagen liefern. ucited unterscheidet dabei methodisch sauber zwischen einer bloßen Erwähnung und einer tatsächlichen Quellen-Zitation.
Welche Arten von Originaldaten funktionieren als Zitations-Trigger?
Antwort-Block: Als Zitations-Trigger eignen sich Daten, die eine Frage direkt beantworten, eine klare Herkunft haben und sich in einem Satz wiedergeben lassen. Am stärksten wirken eigene Messreihen, Benchmarks und Auswertungen aus dem laufenden Betrieb eines Produkts, weil sie weder kopiert noch aus öffentlichen Quellen rekonstruiert werden können.
Typische Formate:
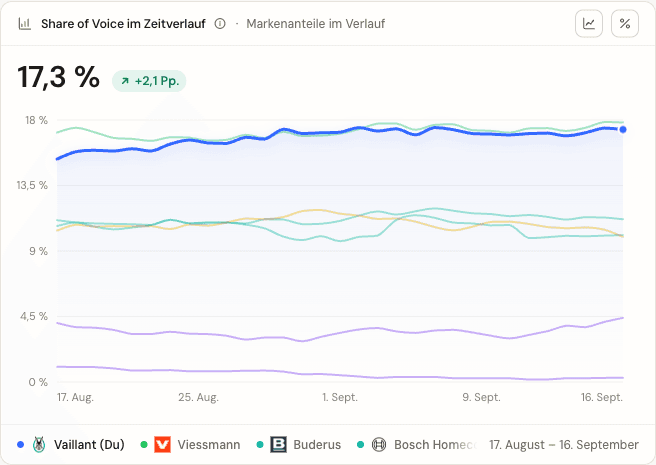
- Eigene Messreihen. Beispiel für ucited.ai: die Zitationshäufigkeit einer Domain pro Modell über einen Zeitraum, wie in der Tabelle oben. Solche Daten fallen im LLM-Citation-Monitoring ohnehin an.
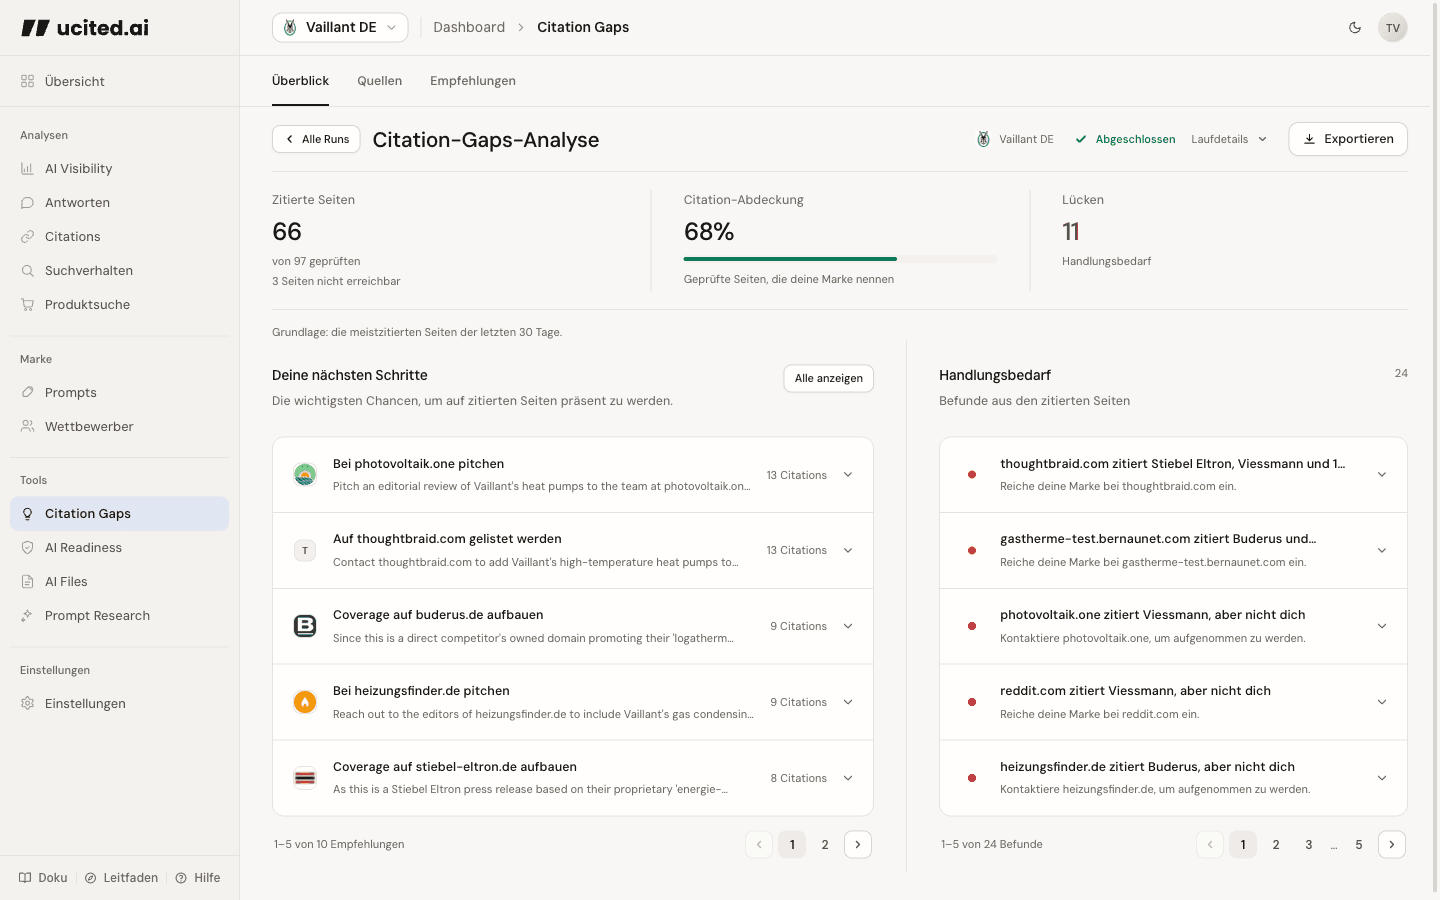
- Quellen-Landschaften pro Thema. Welche Domains werden für ein Fragencluster zitiert, wie verteilt sich der Citation Share of Voice? Das ist eine originäre Auswertung, die kein Konkurrent identisch besitzt.
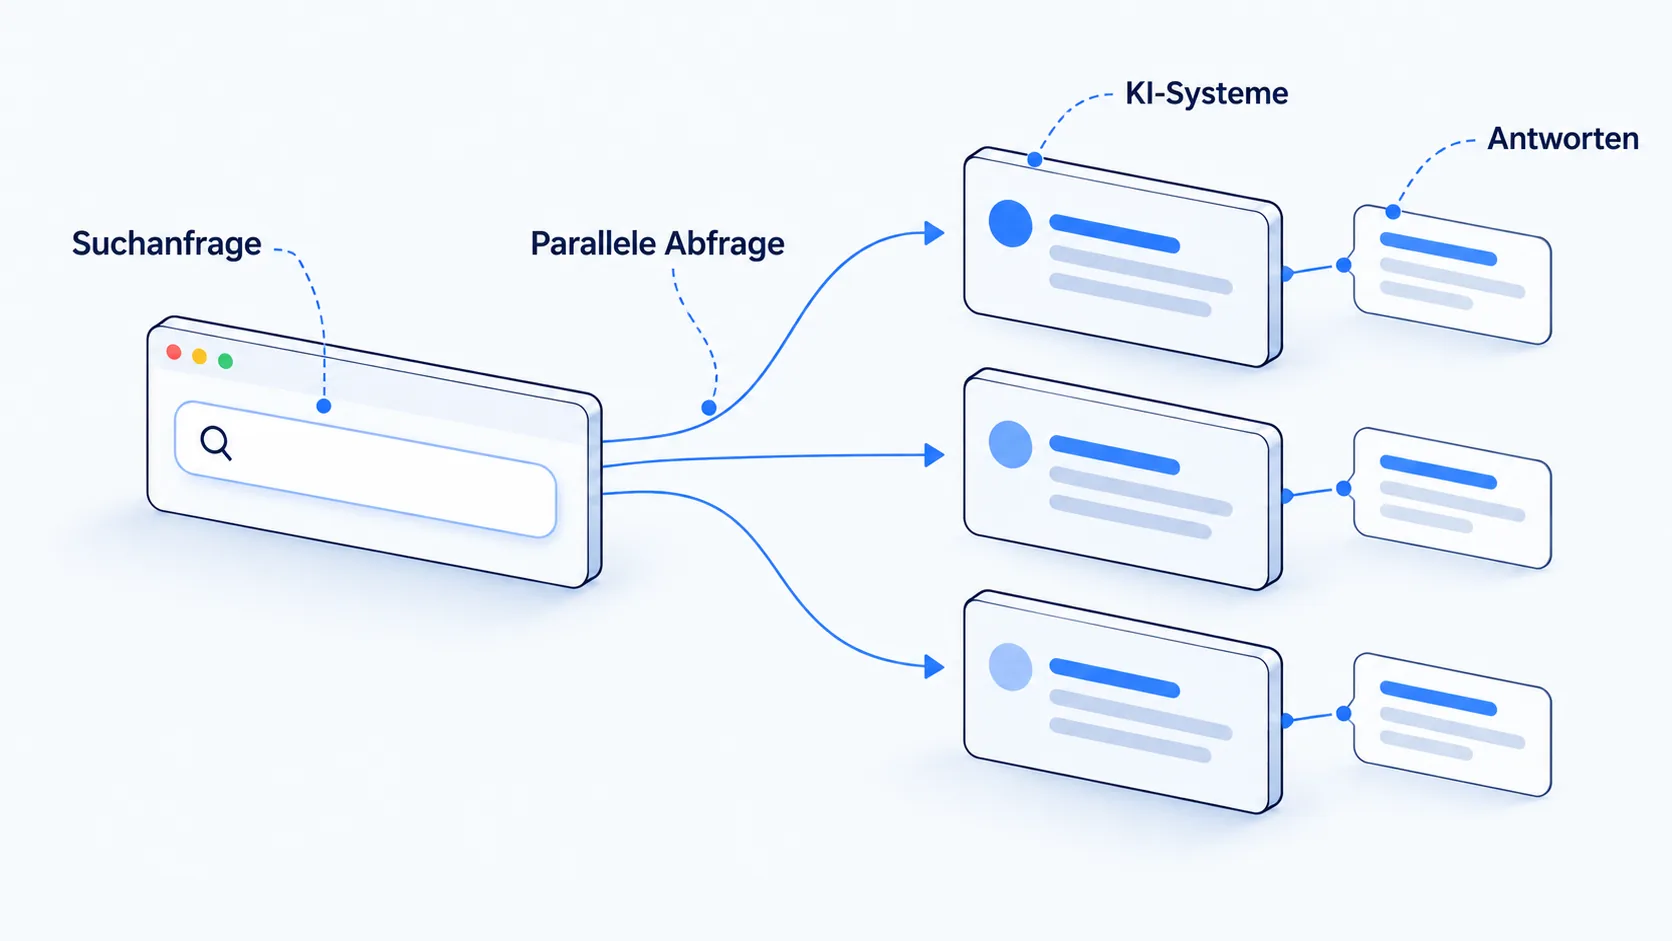
- Vergleiche zwischen Modellen. ChatGPT, Perplexity, Copilot und Google AI Overviews zitieren unterschiedlich. Unterschiede sind zitierfähig, wenn sie sauber belegt sind.
- Umfragen und Befragungen. Nur mit dokumentierter Methodik, Stichprobengröße und Zeitraum. Ohne diese Angaben verliert die Zahl ihre Belegfunktion.
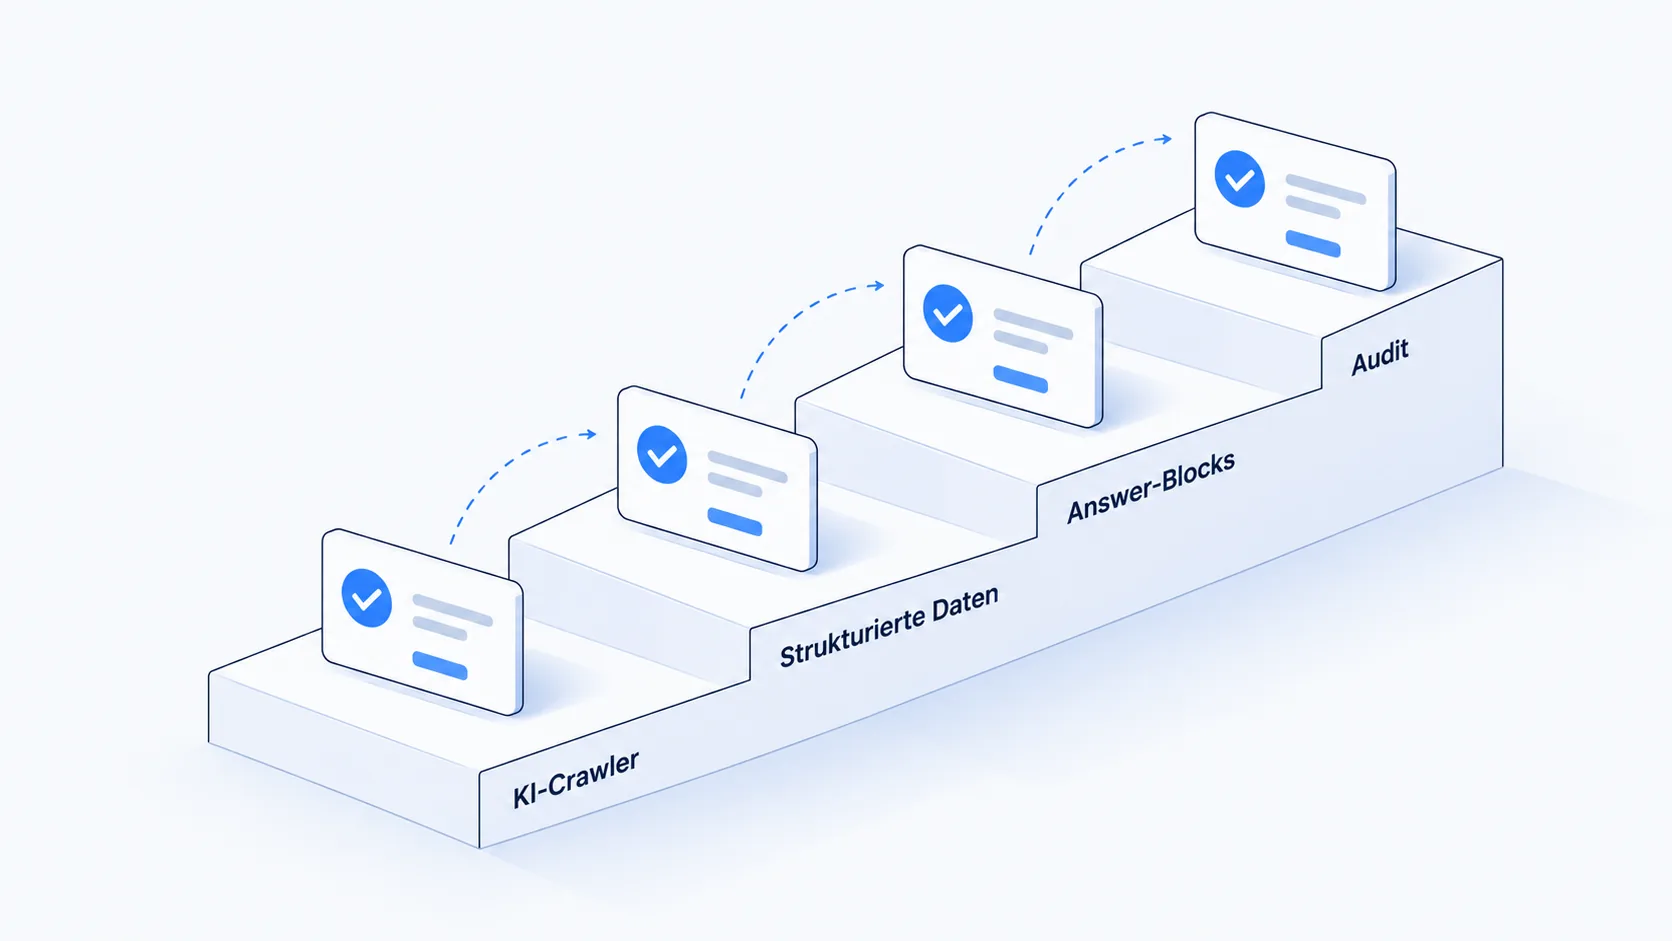
- Benchmark-Tests. Beispiel: Wie verändert sich die Zitationsrate einer Seite nach Einführung von Answer-Blocks? Ein kontinuierliches Monitoring hält genau solche Vorher-Nachher-Messungen fest.
Was nicht funktioniert: aus Drittquellen abgeschriebene Zahlen ohne Mehrwert, Rundungen ohne Herkunft ("über 80 % der Unternehmen") und Aussagen, die sich nicht auf einen konkreten Datensatz zurückführen lassen.
Wie bereitet man Statistiken so auf, dass KI-Modelle sie übernehmen?
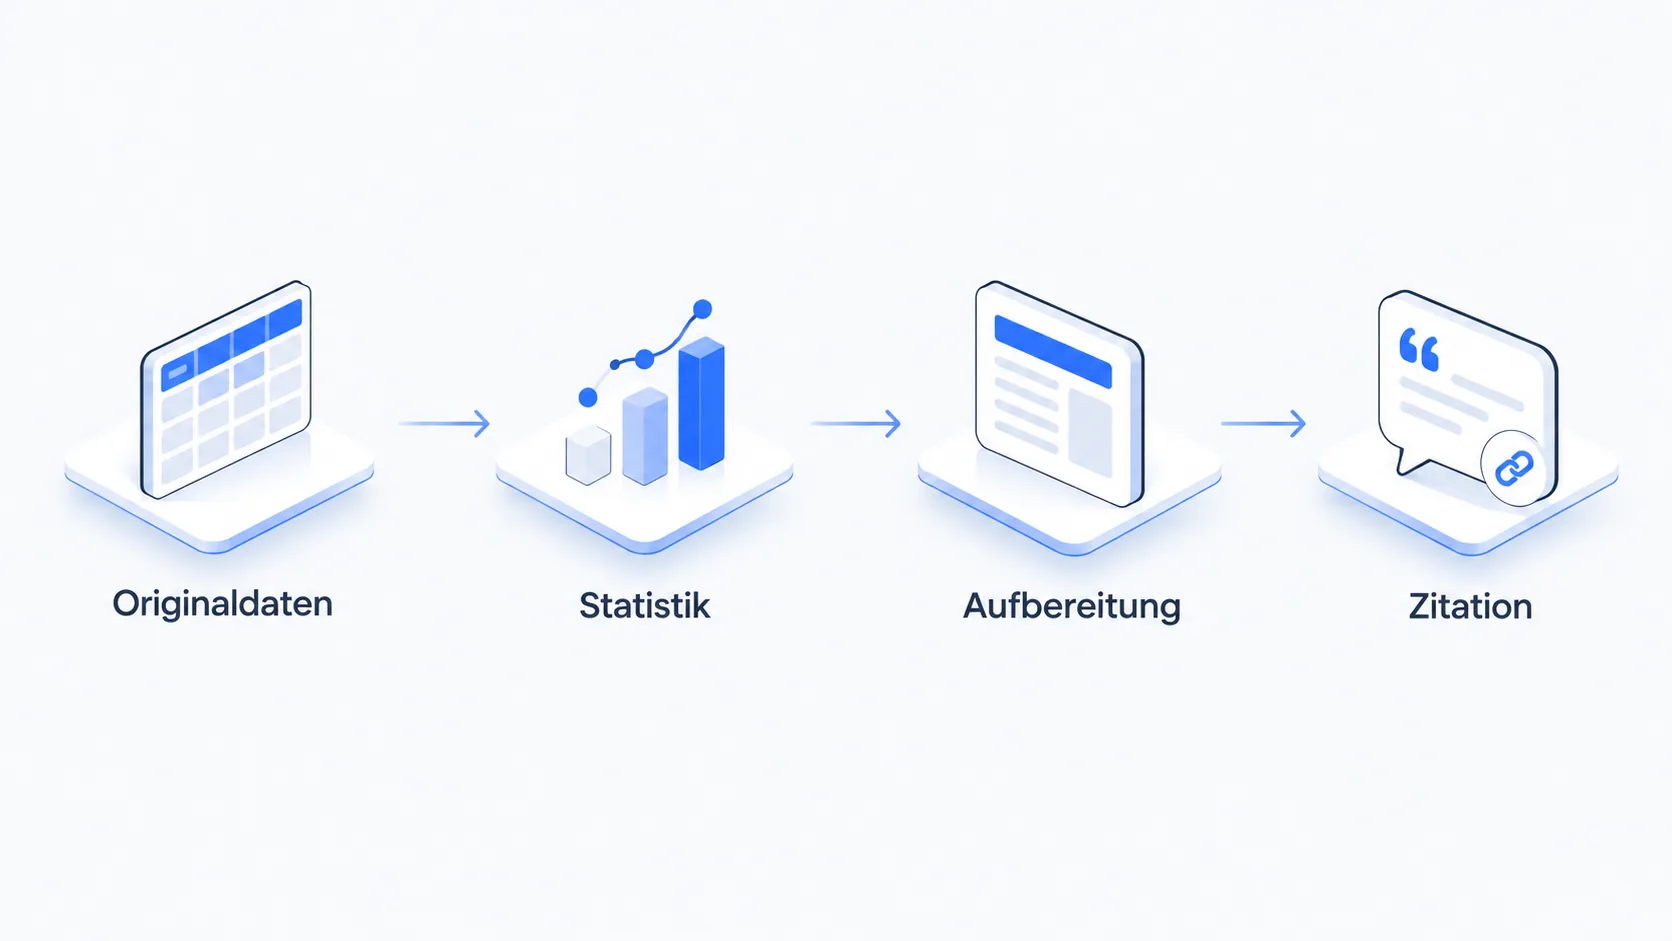
Antwort-Block: Eine zitierfähige Statistik besteht aus vier Elementen in einem Absatz: der Zahl, dem Kontext (was wurde gemessen, wann, an wem), der Quelle und der Schlussfolgerung. Der Absatz muss ohne den Rest der Seite verständlich sein, weil generative Suchmaschinen Textpassagen isoliert bewerten und übernehmen.
Konkrete Regeln:
- Ein Datenpunkt, ein Absatz. Keine Absätze, die drei Zahlen mischen. Jede Zahl bekommt ihren eigenen Kontext.
- Herkunft im Satz, nicht in der Fußnote. „Laut Monitoring vom September 2026 wurde arxiv.org bei diesem Prompt in rund einem Viertel der ChatGPT-Beobachtungen genannt“ ist übernehmbar. Eine hochgestellte Ziffer ist es nicht.
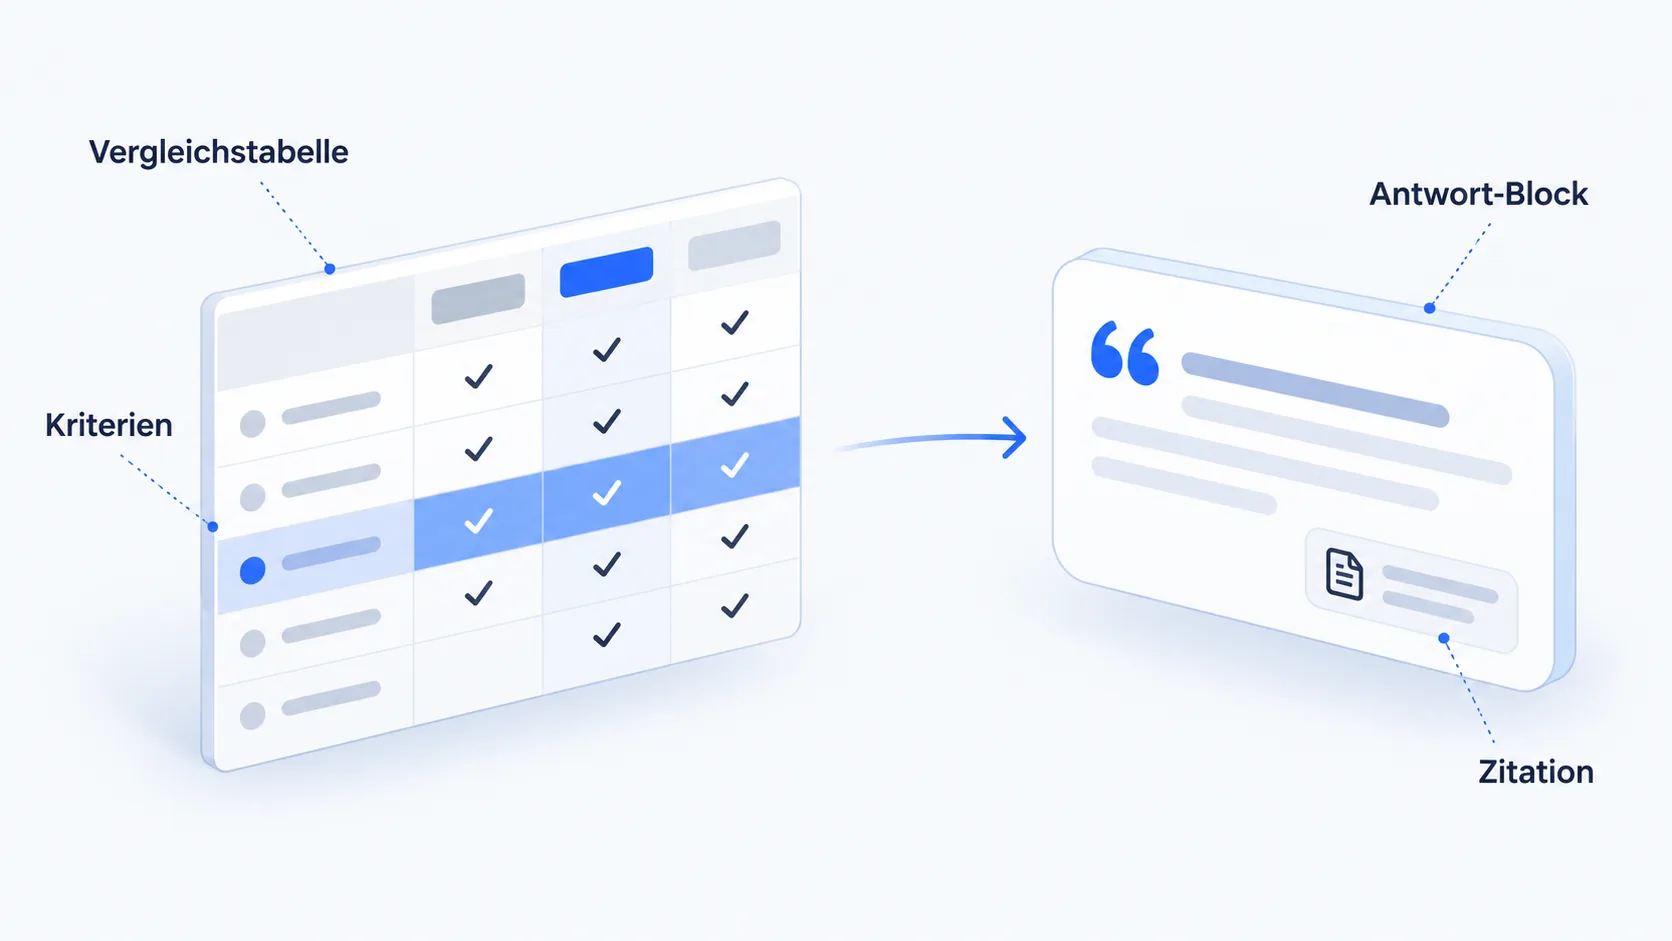
- Tabellen für Vergleiche, Prosa für Einzelwerte. Tabellen strukturieren mehrdimensionale Daten, wie Yu et al. (2026) zeigt. Der zentrale Einzelwert steht zusätzlich als Satz im Text.
- Zeitstempel setzen. Ohne Datum kann das Modell nicht einschätzen, ob die Zahl aktuell ist.
- Methodik verlinken oder beschreiben. Stichprobe, Zeitraum, Messverfahren. Das erhöht die Glaubwürdigkeit für Modelle, die Quellen gegeneinander abwägen.
- Frage als Heading formulieren. Die H2 sollte der Nutzerfrage entsprechen, der Answer-Block direkt darunter beantwortet sie vollständig.
Was bedeutet das für ucited.ai?
Antwort-Block: ucited.ai misst Zitationshäufigkeit, Citation Share of Voice und Quellen-Landschaften in LLM-Antworten und erzeugt damit laufend Originaldaten, die als Zitations-Trigger geeignet sind. Ein naheliegender Schritt ist, ausgewählte Monitoring-Auswertungen als eigenständige, belegte Answer-Blocks zu veröffentlichen.
Konkrete Ansatzpunkte, die sich aus den vorhandenen Daten ergeben:
- Die Quellen-Landschaft pro Themencluster (wie oben) als regelmäßig aktualisierte Auswertung publizieren, mit Datum und Beobachtungszahl.
- Die methodisch saubere Unterscheidung zwischen Erwähnung und tatsächlicher Quellen-Zitation je Modell transparent dokumentieren. Das ist ein methodischer Originalbeitrag, den kaum ein Wettbewerber bietet.
- Den gemessenen Effekt einzelner Maßnahmen als eigene Datenreihe veröffentlichen, sobald Vorher-Nachher-Messungen vorliegen.
Keine Aussagen zu Kundenzahlen, Preisen oder Erfolgsquoten von ucited.ai, da hierfür keine Daten in den Tools vorliegen.
Häufige Fragen
Reichen Statistiken aus Drittquellen, um zitiert zu werden?
Selten. Wenn die Zahl auch bei der Originalquelle steht, zitiert das Modell mit hoher Wahrscheinlichkeit die Originalquelle. Drittstatistiken helfen nur, wenn sie mit eigener Auswertung, Einordnung oder Kombination angereichert werden.
Wie viele Zahlen braucht eine Seite?
Es gibt keine belastbare allgemeine Mindestanzahl. Entscheidend ist, dass jede Zahl belegt, datiert und in einem selbstenthaltenden Absatz steht. Eine gut belegte Zahl ist mehr wert als zehn ohne Herkunft.
Zitieren alle KI-Suchmaschinen gleich?
Nein. ucited unterscheidet methodisch sauber zwischen einer bloßen Erwähnung und einer tatsächlichen Quellen-Zitation und wertet das Zitationssignal nur dort, wo es semantisch belastbar ist. Vergleiche über Modelle hinweg müssen diese Unterschiede in der Messmethodik ausweisen.
Wie schnell wirkt das Hinzufügen von Statistiken?
Dazu gibt es noch keine belastbaren Vorher-Nachher-Messungen; die Einschätzung beruht auf dem Stand der Forschung.
Wie lässt sich der Effekt messen?
Über ein LLM-Citation-Monitoring, das pro Prompt und Modell festhält, ob und wie oft eine Domain zitiert wird, wie in den Tabellen oben. Ein Vorher-Nachher-Vergleich derselben Prompts nach Veröffentlichung der Statistiken zeigt die Veränderung der Zitationsrate.