Vergleichsartikel und Listicles werden von KI-Assistenten wie ChatGPT, Perplexity oder Google AI Overviews dann als Quelle genutzt, wenn jede Sektion eine eigenständige, direkt übernehmbare Antwort enthält: eine klare Kernaussage in zwei bis vier Sätzen, konsistente Vergleichskriterien pro Eintrag und belegbare Aussagen statt Werbeversprechen. Der Grund ist einfach: Ein Sprachmodell extrahiert Passagen, nicht ganze Seiten. Wer seine Vergleichsblöcke so schreibt, dass sie ohne den Rest der Seite verständlich sind, erhöht die Chance, dass genau dieser Block zitiert wird. Dieser Guide zeigt, wie das Format konkret aussieht und wie sich der Effekt mit LLM-Citation-Monitoring messen lässt.
Warum KI-Assistenten Vergleichsartikel überhaupt zitieren
KI-Assistenten zitieren Vergleichsartikel, weil Nutzerfragen nach dem „besten Tool für X“ oder „A vs. B“ zu den häufigsten kommerziellen Suchintentionen gehören und Vergleichsseiten diese Fragen bereits in strukturierter Form beantworten. Modelle mit Web-Zugriff suchen nach Passagen, die die Frage vollständig abdecken, mehrere Optionen nebeneinanderstellen und nachvollziehbare Kriterien nennen. Ein Vergleichsartikel, der genau das leistet, liefert dem Modell fertige Bausteine für seine Antwort.
Im Umkehrschluss: Listen ohne klare Kriterien, mit reinem Marketing-Text oder ohne selbsterklärende Absätze werden seltener übernommen, weil das Modell keine zitierfähige Einheit findet.
Wie die Quellenlage bei dieser Frage aktuell aussieht
Für die Frage „Wie schreibe ich Vergleichsartikel und Beste-Tools-Listen, die von KI-Assistenten als Quelle genutzt werden?“ (deutsch und englisch) zeigen die Beobachtungen ein gemischtes Bild aus Tool-Anbietern, Plattform-Dokumentation und Fachblogs:
- Bei der englischen Variante der Frage dominieren spezialisierte GEO-Anbieter wie getmasset.com, trackmyvisibility.com und unusual.ai, daneben developers.google.com (Auswertung der ucited-Zitationsdaten, Stand September 2026).
- Bei der deutschen Variante liegen Plattform-Dokumentationen vorn, etwa help.openai.com, openai.com und developers.google.com, dahinter deutsche Fachblogs wie web-mastery.de und provimedia.de.
- Ein großer Teil der Antworten kommt ganz ohne explizite Quelle aus, der Wettbewerb um die wenigen Zitatplätze ist entsprechend hoch.
Das zeigt zwei Dinge. Erstens: Ein großer Teil der Antworten kommt ohne explizite Quelle aus, der Wettbewerb um die wenigen Zitatplätze ist entsprechend hoch. Zweitens: Die zitierten Seiten sind fast durchgehend Anleitungs- und Dokumentationsformate, keine reinen Produktseiten.
Das Grundprinzip: Jeder Eintrag ist ein selbstenthaltender Antwort-Block
Ein zitierfähiger Eintrag in einer Vergleichsliste beantwortet in zwei bis vier Sätzen, was das Tool ist, für wen es sich eignet und worin es sich von den Alternativen unterscheidet, ohne dass der Leser die Einleitung oder andere Einträge kennen muss. Erst danach folgen Details, Screenshots oder Preisangaben. Dieses Muster wird in der GEO-Literatur als „Answer Block“ bezeichnet; seine Wirkung auf die Zitationswahrscheinlichkeit ist eine Arbeitshypothese aus der Literatur (Tian et al. (2026) untersucht diagnosegetriebene Content-Reparatur, nicht dieses Format), nicht abschließend quantifiziert.
Konkret bedeutet das für jeden Listeneintrag:
- Erster Satz: Einordnung. Was ist das Tool und welche Kategorie bedient es? Kein Slogan, sondern eine Definition.
- Zweiter Satz: Zielgruppe oder Einsatzfall. Für wen oder wofür ist es die passende Wahl?
- Dritter Satz: Abgrenzung. Was unterscheidet es von den anderen Einträgen der Liste?
- Optional vierter Satz: Einschränkung. Wo liegt die Grenze oder der typische Nachteil?
Ein Block, der diese vier Punkte abdeckt, kann von einem KI-Assistenten wörtlich oder sinngemäß übernommen werden, ohne dass Kontext fehlt.
Beispiel: schwacher vs. zitierfähiger Eintrag
Schwach:
Tool X ist die Nummer eins für alle, die mehr aus ihrem Content machen wollen. Jetzt kostenlos testen!
Zitierfähig:
Tool X ist eine Monitoring-Lösung, die misst, wie häufig eine Domain in Antworten von ChatGPT, Perplexity und Google AI Overviews als Quelle erscheint. Es richtet sich an Content- und SEO-Teams, die den Erfolg von GEO-Maßnahmen quantifizieren wollen. Im Unterschied zu klassischen Rank-Trackern erfasst es Zitationen statt Positionen. Für die Analyse einzelner Antworttexte ist es nicht ausgelegt.
Der zweite Block ist ohne die restliche Seite verständlich und enthält keine Behauptung, die ein Modell nicht sinnvoll wiedergeben könnte.
Struktur eines Vergleichsartikels, der zitiert wird
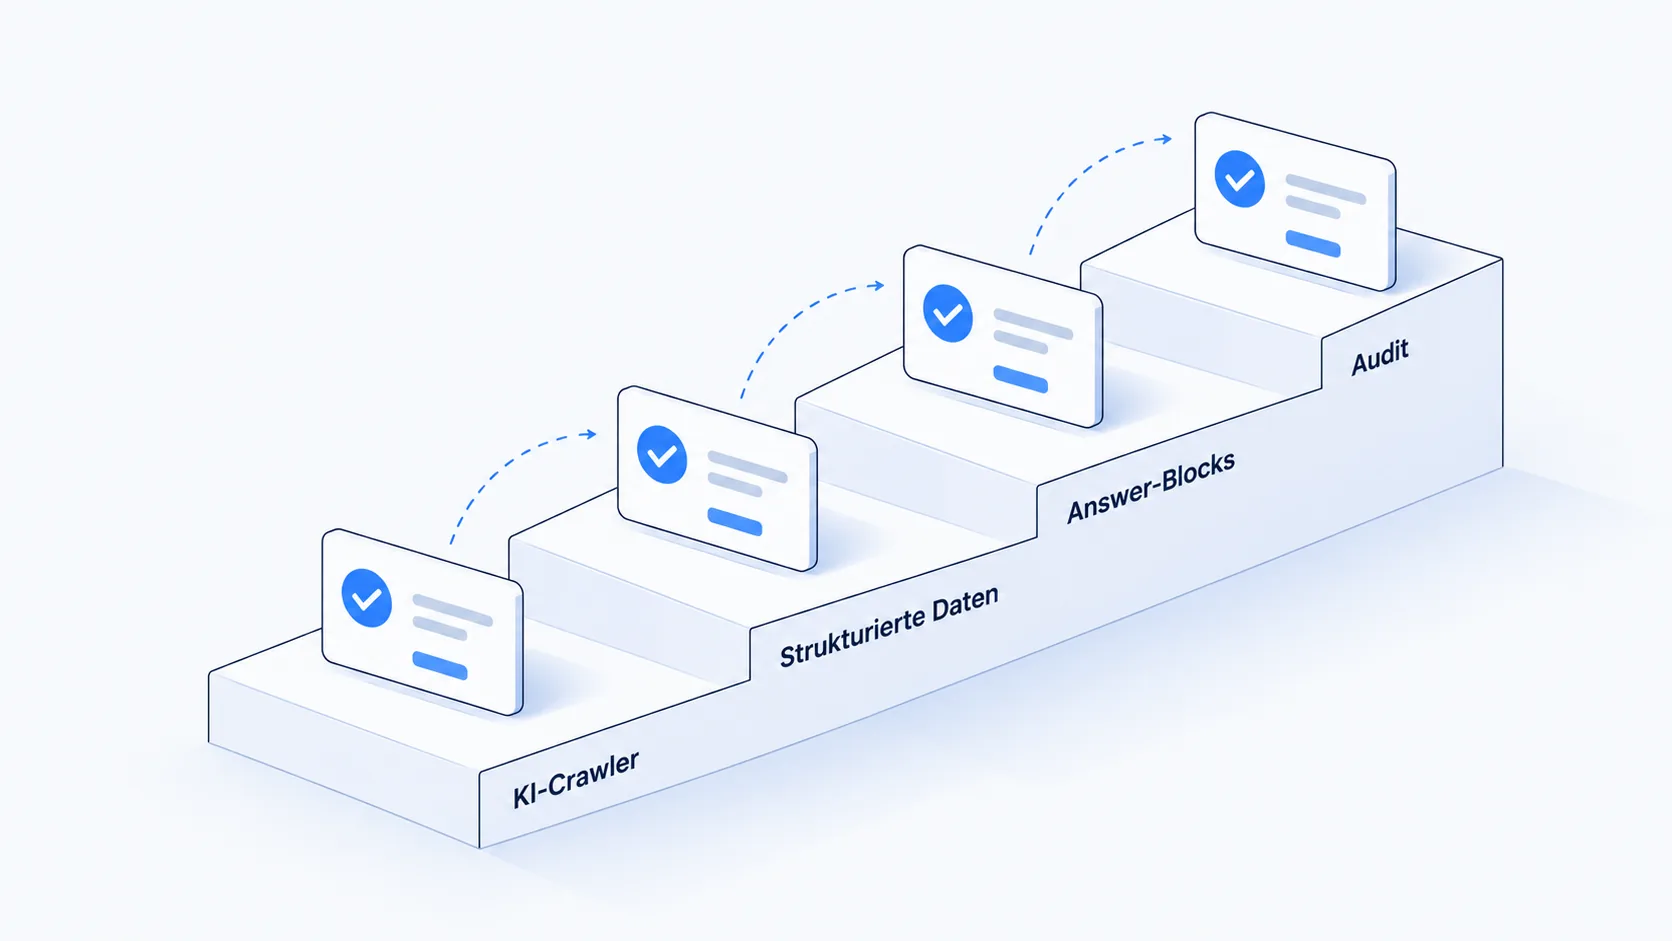
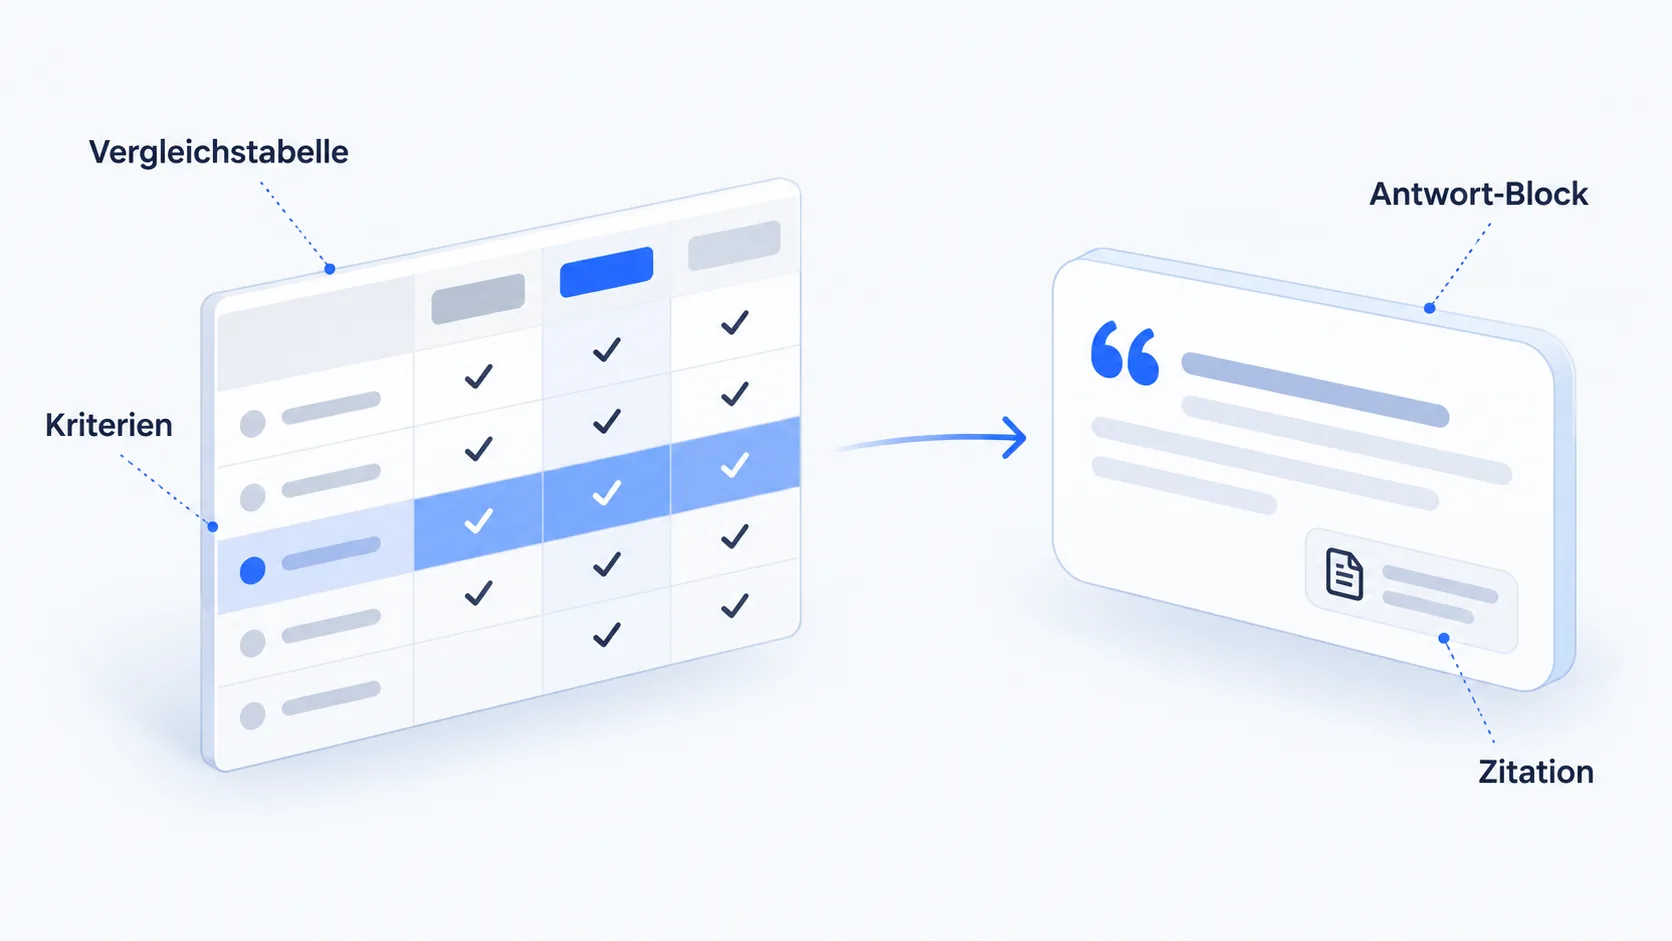
Ein zitierfähiger Vergleichsartikel besteht aus einer Kurzantwort direkt unter der H1, einer Kriterienliste, einem Eintrag pro Tool mit identischem Aufbau, einer Vergleichstabelle und einer FAQ-Sektion. Jede dieser Einheiten ist für sich extrahierbar; der Artikel funktioniert damit sowohl als Ganzes für menschliche Leser als auch als Sammlung von Einzelblöcken für Sprachmodelle.
1. Kurzantwort direkt unter der Überschrift
Die ersten zwei bis vier Sätze beantworten die Titelfrage vollständig: Welche Tools werden verglichen, nach welchen Kriterien, und was ist die Kernaussage? Wer nur diesen Absatz liest oder zitiert, hat bereits die Antwort.
2. Vergleichskriterien explizit machen
Nenne die Kriterien, nach denen du bewertest, in einer eigenen Liste, bevor der erste Eintrag beginnt. Beispiele für Tool-Vergleiche im GEO-Bereich:
- Welche KI-Systeme werden abgedeckt (ChatGPT, Perplexity, Google AI Overviews, Copilot, Gemini)?
- Wird Zitation gemessen oder nur Markennennung?
- Gibt es eine Citation-Share-of-Voice-Auswertung gegenüber Wettbewerbern?
- Wie granular sind die Prompt-Sets (eigene Prompts, Branchen-Sets, Sprachen)?
- Exportmöglichkeiten und Reporting
Explizite Kriterien geben dem Modell die Begriffe vor, mit denen es deine Einträge später zusammenfasst.
3. Identischer Aufbau pro Eintrag
Jeder Tool-Eintrag folgt exakt derselben Reihenfolge: Answer-Block, dann Kriterien in gleicher Reihenfolge, dann Einschränkungen. Konsistenz erleichtert die Extraktion und verhindert, dass ein Eintrag nur deshalb bevorzugt wird, weil er zufällig vollständiger geschrieben ist.
4. Vergleichstabelle als zweite Zitationsebene
Eine Tabelle mit Tools in Zeilen und Kriterien in Spalten ist für Sprachmodelle gut verwertbar, weil sie strukturierte Aussagen liefert („Tool A: ja, Tool B: nein“). Die Tabelle ersetzt aber nicht die Answer-Blocks, sie ergänzt sie.
5. FAQ-Sektion für Folgefragen
Typische Nachfragen („Was kostet …“, „Gibt es eine kostenlose Variante …“, „Für welche Teamgröße …“) als eigene H3 mit jeweils einer Kurzantwort. Jede Frage-Antwort-Kombination ist ein weiterer selbstenthaltender Block.
Häufige Fehler, die Zitationen verhindern
Die häufigsten Gründe, warum Vergleichsartikel nicht zitiert werden, sind fehlende Kurzantworten, inkonsistente Einträge, unbelegte Superlative und Inhalte, die nur in Bildern oder interaktiven Elementen stecken. Jeder dieser Fehler nimmt dem Modell die extrahierbare Texteinheit.
- Einleitung ohne Antwort. Drei Absätze über die Bedeutung von GEO, bevor das erste Tool genannt wird. Das Modell findet keine Kernaussage.
- Superlative ohne Beleg. „Das beste Tool am Markt“ ist keine übernehmbare Aussage. „Deckt als einziges der verglichenen Tools Copilot ab“ ist eine.
- Uneinheitliche Einträge. Tool A bekommt 400 Wörter mit Kriterien, Tool B zwei Sätze. Das Modell kann nicht vergleichen.
- Inhalte nur in Grafiken. Vergleichstabellen als Screenshot sind für Textextraktion unsichtbar.
- Veraltete Angaben ohne Datum. Preise und Features ändern sich. Ohne sichtbares Aktualisierungsdatum sinkt die Vertrauenswürdigkeit der Passage.
Wie du misst, ob deine Vergleichsseite zitiert wird
Ob eine Vergleichsseite von KI-Assistenten zitiert wird, lässt sich nur durch systematisches Monitoring feststellen: dieselben Prompts werden regelmäßig an ChatGPT, Perplexity, Google AI Overviews und weitere Systeme gestellt, und die zitierten Quellen werden protokolliert. Ein GEO-Analytics-Tool wie ucited.ai automatisiert diesen Schritt und zeigt, welche Domains bei einem Prompt-Set aktuell zitiert werden, wie sich der eigene Citation Share of Voice entwickelt und ob eine Änderung am Seitenformat eine messbare Wirkung hatte.
Sinnvolles Vorgehen für Vergleichsartikel:
- Prompt-Set definieren. Die Fragen formulieren, die Nutzer zu deiner Vergleichsseite stellen würden, in allen relevanten Sprachen.
- Baseline erfassen. Vor der Umstellung auf Answer-Blocks messen, welche Domains zitiert werden und wie oft die eigene Domain erscheint.
- Format umstellen. Answer-Blocks, konsistente Kriterien und Tabelle einbauen.
- Nachmessen. Über mehrere Wochen beobachten, ob sich die Zitationsrate der eigenen Domain verändert. Einzelne Beobachtungen schwanken stark; erst wiederholte Messungen sind aussagekräftig.
- Quellenlandschaft prüfen. Welche Wettbewerber verlieren oder gewinnen Anteile? Welche Formate nutzen die aktuell zitierten Seiten?
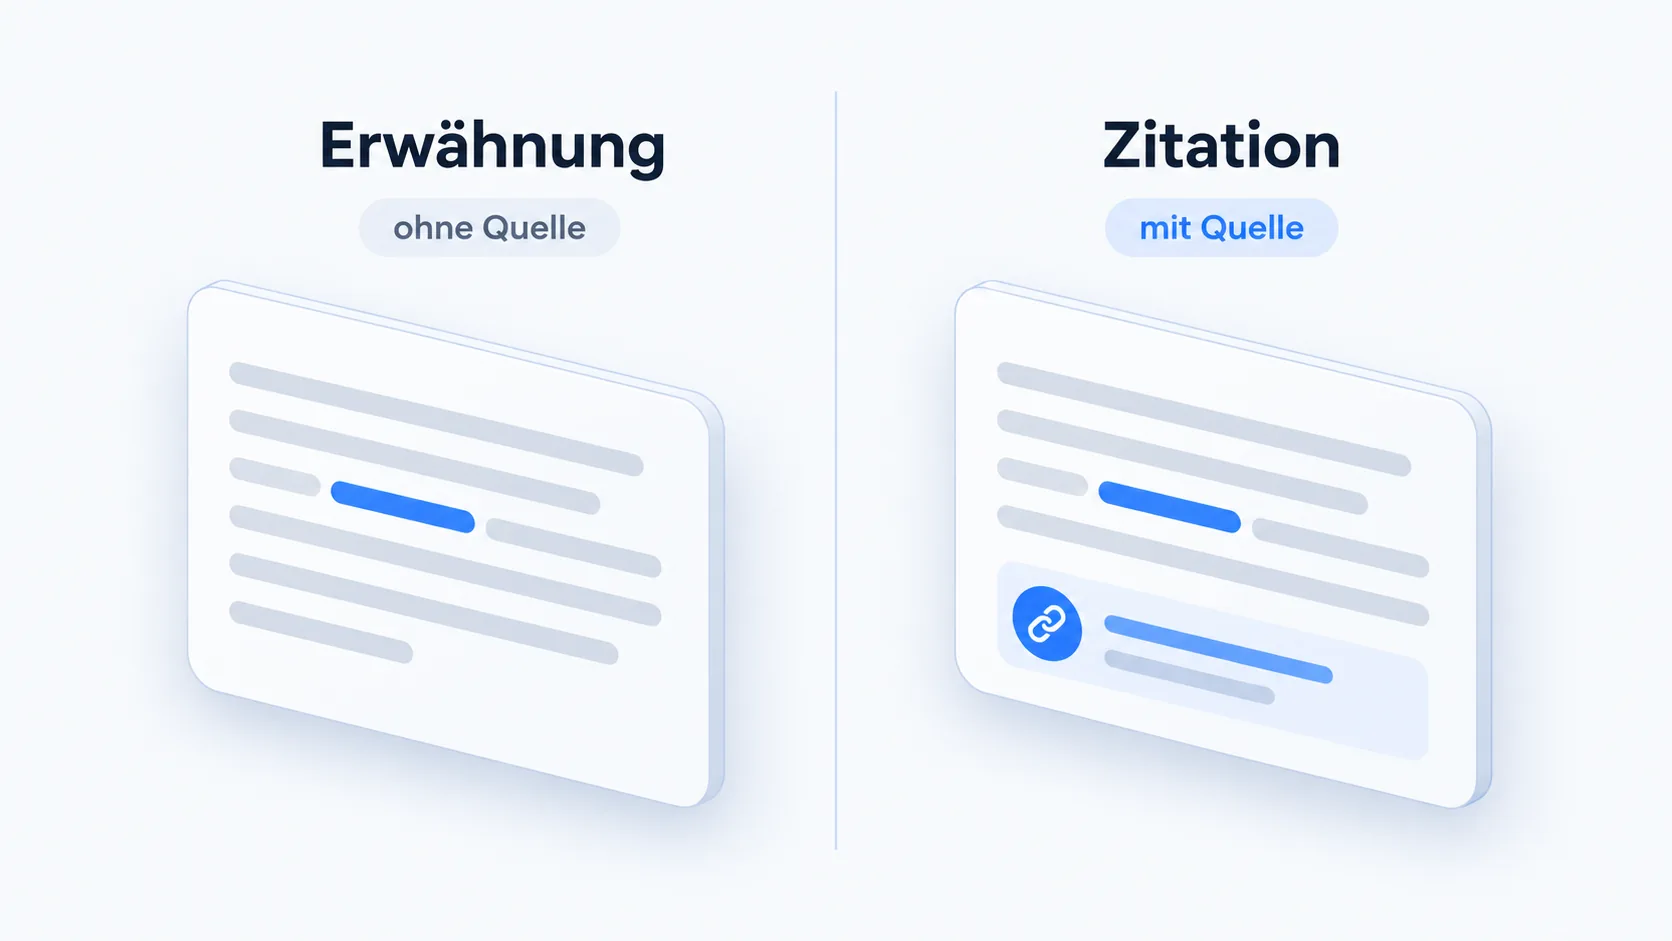
Hinweis zur Interpretation: Nicht jedes KI-System liefert saubere Zitationssignale. ucited unterscheidet methodisch sauber zwischen einer bloßen Erwähnung und einer tatsächlichen Quellen-Zitation und wertet das Signal nur dort, wo es semantisch belastbar ist. Vergleichbare Einschränkungen sollte jedes Monitoring transparent machen.
Häufige Fragen
Wie lang sollte ein Answer-Block in einem Vergleichsartikel sein?
Zwei bis vier Sätze, die Einordnung, Zielgruppe und Abgrenzung abdecken. Länger wird der Block schwerer extrahierbar, kürzer fehlt meist die Abgrenzung zu den Alternativen.
Muss jeder Vergleichsartikel eine Tabelle enthalten?
Nein, aber eine Tabelle liefert eine zweite, strukturierte Extraktionsebene. Wichtig ist, dass sie als HTML-Tabelle vorliegt und nicht als Bild.
Werden Listen mit vielen Einträgen häufiger zitiert als kurze?
Dazu gibt es keine belastbaren allgemeinen Daten. Entscheidend ist eher, dass jeder Eintrag vollständig und konsistent aufgebaut ist, als dass die Liste lang ist.
Wie schnell zeigt sich eine Umstellung auf Answer-Blocks im Monitoring?
Ein fester Zeitraum lässt sich nicht pauschal angeben. Da KI-Systeme Quellen unterschiedlich schnell neu abrufen, sollte die Nachmessung über mehrere Wochen laufen und mehrere Beobachtungen pro Prompt umfassen.
Reicht es, den eigenen Anbieter in der Liste zu nennen?
Nein. Eine Vergleichsseite, die nur den eigenen Anbieter positiv darstellt und Alternativen abwertet, liefert dem Modell keine glaubwürdige Vergleichsbasis. Faire, kriterienbasierte Einträge für alle genannten Tools erhöhen die Chance, dass die Seite als neutrale Quelle übernommen wird.