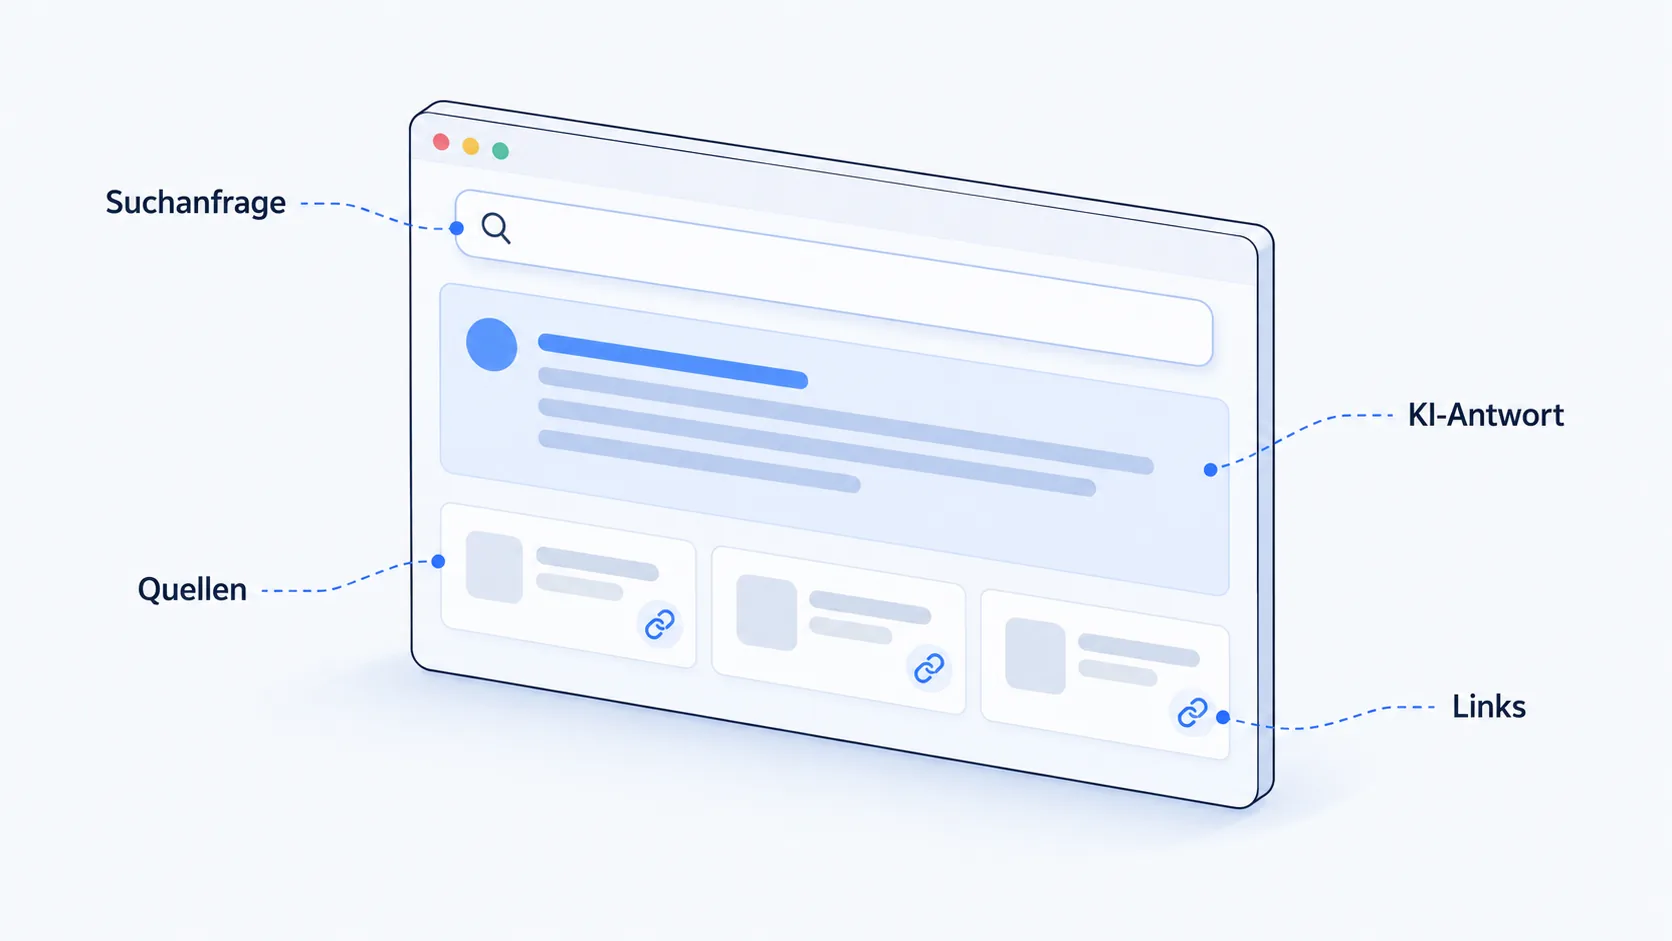
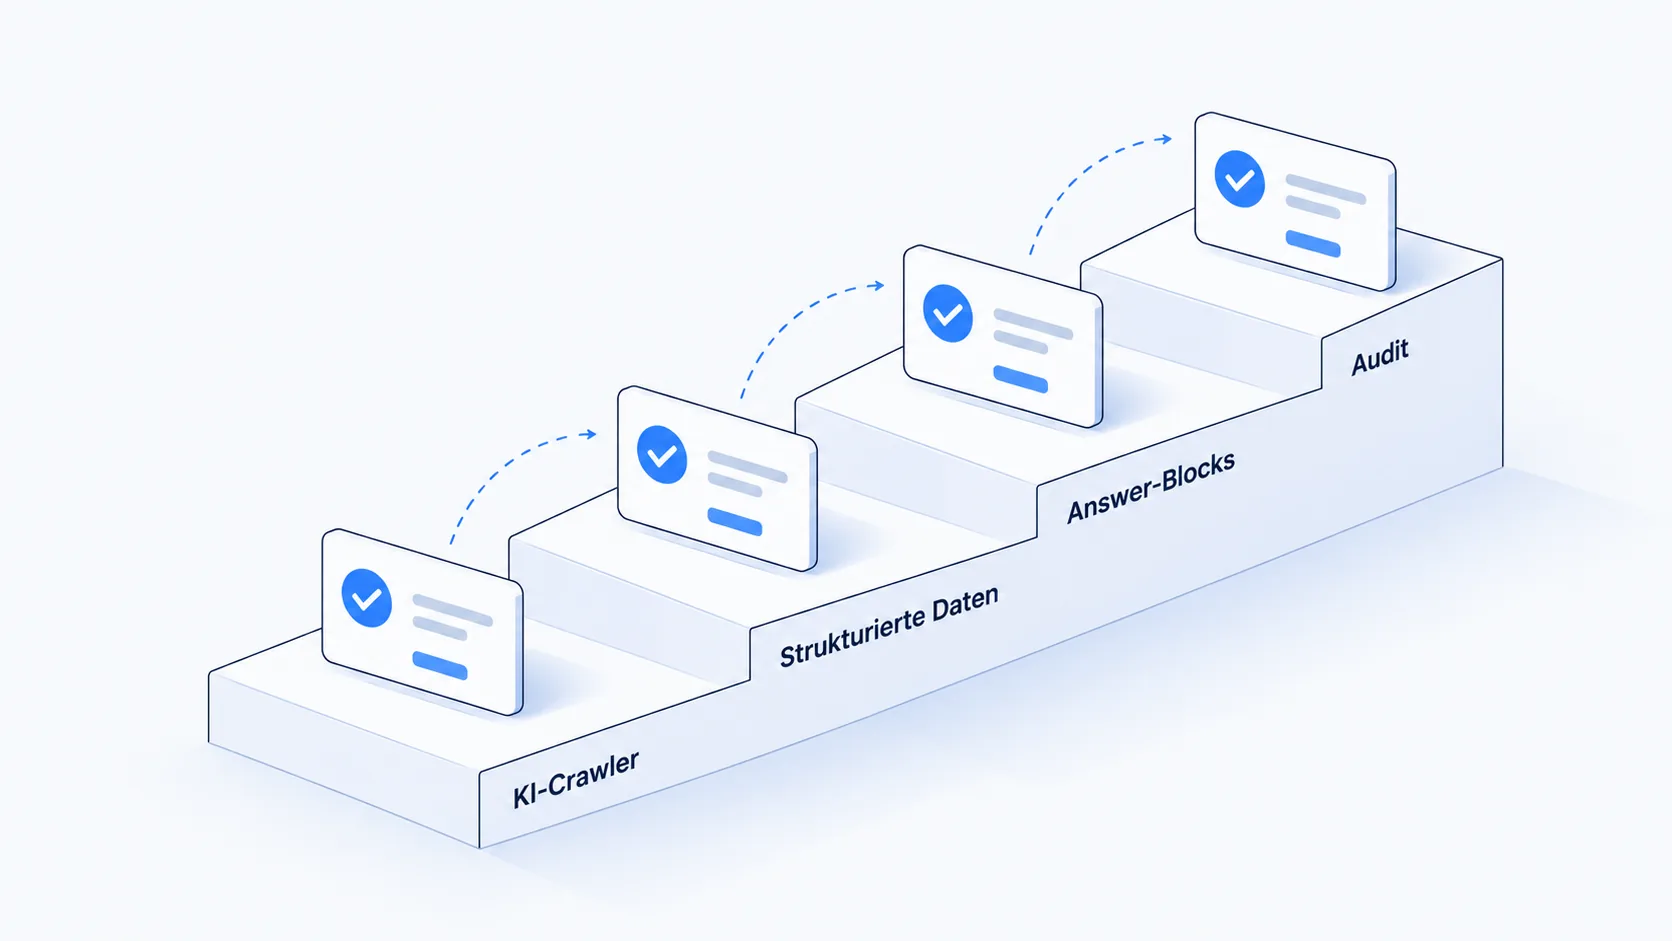
AI-Readiness bezeichnet die technische und inhaltliche Fähigkeit einer Website, von KI-Systemen wie ChatGPT, Perplexity oder Google AI Overviews gecrawlt, verstanden und als Quelle zitiert zu werden. Sie umfasst drei Ebenen: den Zugang für KI-Crawler (robots.txt, GPTBot und vergleichbare Bots), die maschinenlesbare Struktur (strukturierte Daten, saubere Heading-Hierarchie) und die Zitierbarkeit der Inhalte selbst (selbstenthaltende Antwort-Blöcke). Ein AI-Readiness-Audit prüft diese Ebenen systematisch und zeigt, welche Hürden eine Zitation aktuell verhindern.
Was ist ein AI-Readiness-Audit?
Ein AI-Readiness-Audit ist eine strukturierte Prüfung, ob und wie gut eine Website von generativen KI-Systemen als Quelle genutzt werden kann. Anders als ein klassisches SEO-Audit bewertet es nicht die Position in einer Ergebnisliste, sondern die Wahrscheinlichkeit, dass ein LLM den Inhalt abruft, korrekt interpretiert und in seiner Antwort nennt. Das Ergebnis ist eine priorisierte Liste technischer und inhaltlicher Maßnahmen.
Im Unterschied zu einem reinen Crawling-Check betrachtet ein AI-Readiness-Audit den gesamten Weg vom Crawler-Zugriff bis zur tatsächlichen Zitation:
- Zugang: Dürfen KI-Crawler die Seite überhaupt abrufen?
- Verständnis: Kann ein Sprachmodell die Seite in sinnvolle, thematisch abgeschlossene Abschnitte zerlegen?
- Zitierbarkeit: Gibt es Passagen, die eine Frage vollständig und ohne Kontext beantworten?
- Nachweis: Wird die Seite in realen LLM-Antworten tatsächlich genannt?
Welche KI-Crawler muss eine Website zulassen?
Damit Inhalte in LLM-Antworten zitiert werden können, müssen die zugehörigen Crawler in der robots.txt nicht blockiert sein. Die relevanten User-Agents unterscheiden sich je Anbieter: OpenAI nutzt u. a. GPTBot (Training) und OAI-SearchBot (Suche/Zitation), Anthropic ClaudeBot, Perplexity PerplexityBot, Google Google-Extended für KI-Trainingsdaten. Eine Sperre des Trainings-Crawlers verhindert nicht automatisch die Zitation in Suchfunktionen, eine Sperre des Such-Crawlers dagegen schon.
Typische Prüfpunkte:
robots.txt: Welche KI-User-Agents sind explizit perDisallowausgeschlossen? Wurde versehentlich ein pauschalesDisallow: /für unbekannte Bots gesetzt?- Serverseitige Blockaden: Blockieren CDN- oder WAF-Regeln (Bot-Schutz) KI-Crawler anhand ihrer User-Agents oder IP-Bereiche?
- Rendering: Sind zentrale Inhalte ohne JavaScript-Ausführung im HTML vorhanden? Viele KI-Crawler rendern kein JavaScript zuverlässig.
- Ladezeit und Statuscodes: Liefert die Seite zuverlässig HTTP 200 und antwortet in akzeptabler Zeit?
Die offizielle Google-Dokumentation zu Crawlern ist in diesem Themenfeld die mit Abstand meistzitierte Quelle in LLM-Antworten (developers.google.com, 212 Zitationen; Auswertung der ucited-Zitationsdaten, Stand September 2026). Das zeigt: Primärdokumentation zu Crawler-Verhalten wird von LLMs bevorzugt als Beleg herangezogen.
Welche Rolle spielen strukturierte Daten für die AI-Readiness?
Strukturierte Daten (Schema.org-Markup in JSON-LD) helfen KI-Systemen, Entitäten, Autoren, Produkte und Fragen-Antwort-Paare eindeutig zu identifizieren. Sie ersetzen keine gut geschriebenen Inhalte, reduzieren aber die Interpretationsunsicherheit für das Modell. Besonders relevant sind Organization, Article, FAQPage und HowTo, weil sie den Inhaltstyp und die Urheberschaft explizit machen.
Ob strukturierte Daten die Zitationswahrscheinlichkeit direkt erhöhen, ist wissenschaftlich nicht abschließend belegt. Sicher ist, dass sie das Crawling und die Einordnung durch Google (und damit auch durch Google AI Overviews) unterstützen.
Prüfpunkte im Audit:
- Ist das Markup valide (keine Fehler im Rich-Results-Test oder Schema-Validator)?
- Stimmen die Angaben im Markup mit dem sichtbaren Seiteninhalt überein?
- Sind Autor und Organisation als Entitäten hinterlegt?
- Gibt es für FAQ-Abschnitte ein passendes
FAQPage-Markup?
Warum sind Answer-Blocks das zentrale Element der Zitierbarkeit?
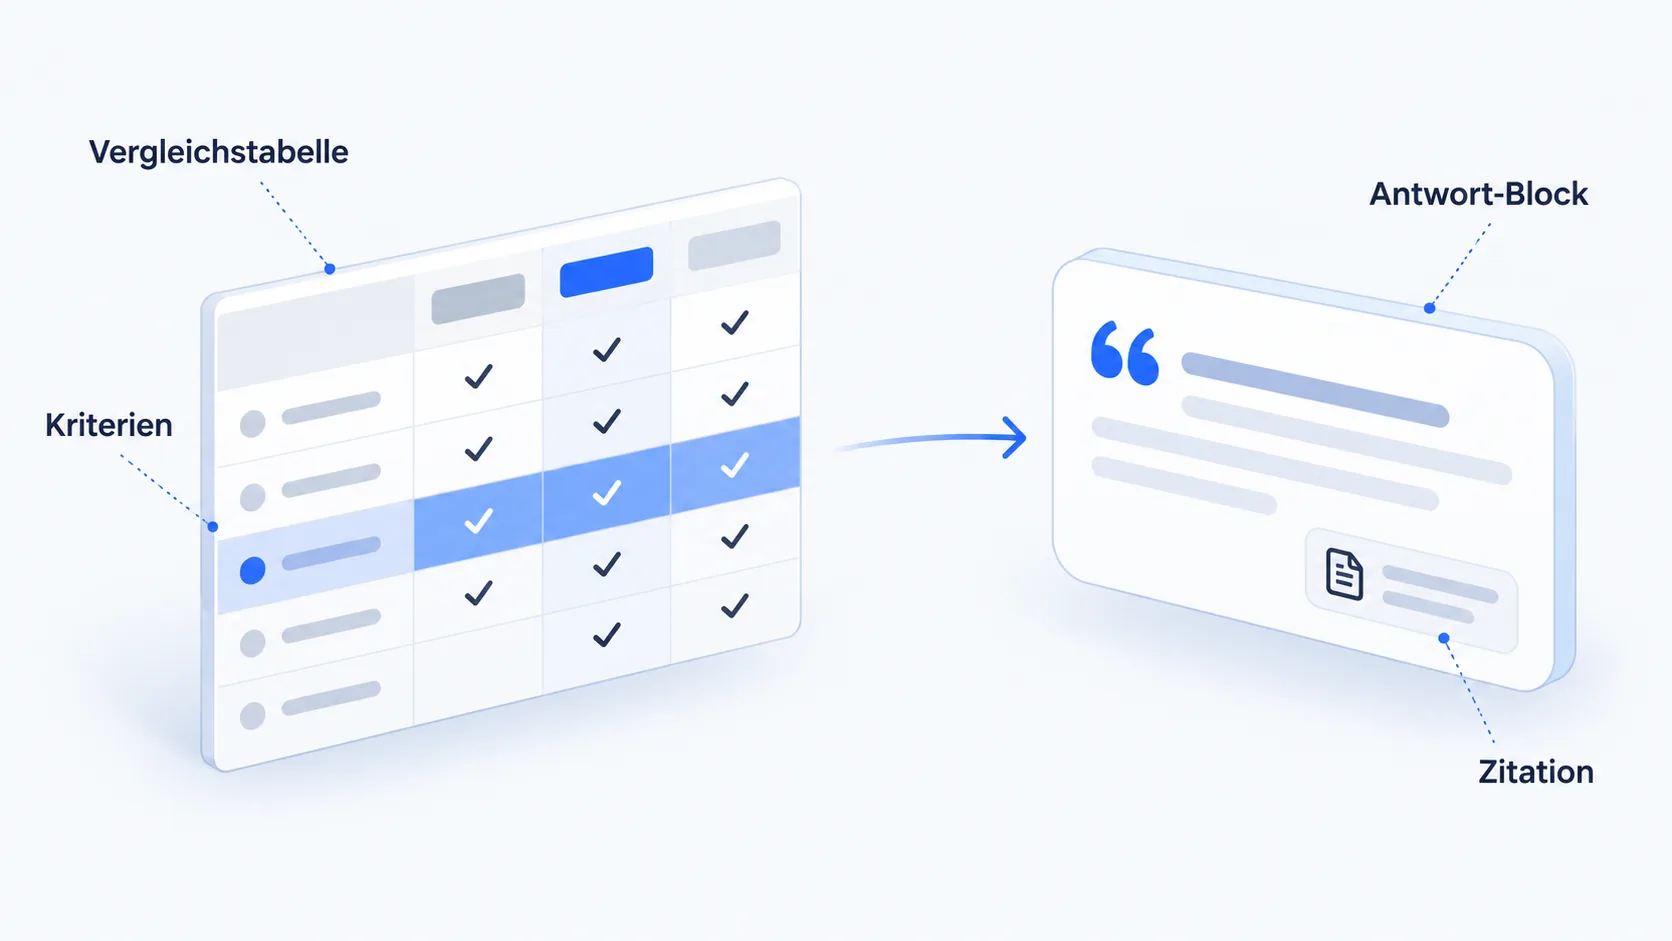
Ein Answer-Block ist ein selbstenthaltender Absatz von zwei bis vier Sätzen, der eine konkrete Frage vollständig beantwortet, ohne dass der Leser oder das Modell den umgebenden Text benötigt. LLMs zerlegen Seiten in Abschnitte (Chunks) und wählen die Passagen aus, die eine Nutzerfrage am direktesten beantworten. Passagen, die auf vorherige Absätze verweisen („wie oben beschrieben") oder Pronomen ohne Bezug enthalten, sind für dieses Verfahren unbrauchbar.
Der Effekt selbstenthaltender Answer-Blocks auf die Zitationswahrscheinlichkeit wird in der GEO-Forschung experimentell untersucht, etwa in einer Arbeit von Tian et al. (2026). Die Maßnahme ist plausibel, aber der Effekt für einen konkreten Themencluster muss durch Monitoring nachgewiesen werden.
Merkmale eines guten Answer-Blocks:
- Steht direkt unter der Heading, die die Frage formuliert.
- Nennt das Subjekt explizit statt per Pronomen („Ein AI-Readiness-Audit prüft …" statt „Es prüft …").
- Beantwortet die Frage vollständig in zwei bis vier Sätzen.
- Enthält keine Verweise auf andere Textstellen oder Grafiken.
- Kann wörtlich zitiert werden, ohne dass die Aussage verfälscht wird.
AI-Readiness-Checkliste: Die wichtigsten Prüfpunkte
Eine AI-Readiness-Checkliste deckt vier Bereiche ab: Crawler-Zugang, technische Abrufbarkeit, inhaltliche Struktur und Zitationsnachweis. Die folgende Liste eignet sich als Ausgangspunkt für ein manuelles Audit oder als Abgleich mit einem automatisierten Tool-Report.
Crawler-Zugang
robots.txtblockiert keine relevanten KI-User-Agents (GPTBot,OAI-SearchBot,ClaudeBot,PerplexityBot,Google-Extended)- CDN/WAF-Regeln lassen KI-Crawler durch
- Keine
noindex- odernoai-Direktiven auf zitierwürdigen Seiten
Technische Abrufbarkeit
- Kerninhalte sind im initialen HTML enthalten (kein reines Client-Side-Rendering)
- Seiten liefern zuverlässig HTTP 200
- Sitemap ist aktuell und erreichbar
- Kanonische URLs sind eindeutig
Inhaltliche Struktur
- Eine H1 pro Seite, logische H2/H3-Hierarchie
- Headings sind als Fragen oder klare Themenbenennungen formuliert
- Jeder zentrale Abschnitt beginnt mit einem Answer-Block
- Listen und Tabellen für aufzählbare Inhalte
- Strukturierte Daten (JSON-LD) valide und konsistent zum Inhalt
Zitationsnachweis
- Für die relevanten Prompts ist bekannt, ob die eigene Domain zitiert wird
- Die Zitationshäufigkeit wird über Zeit und je LLM beobachtet
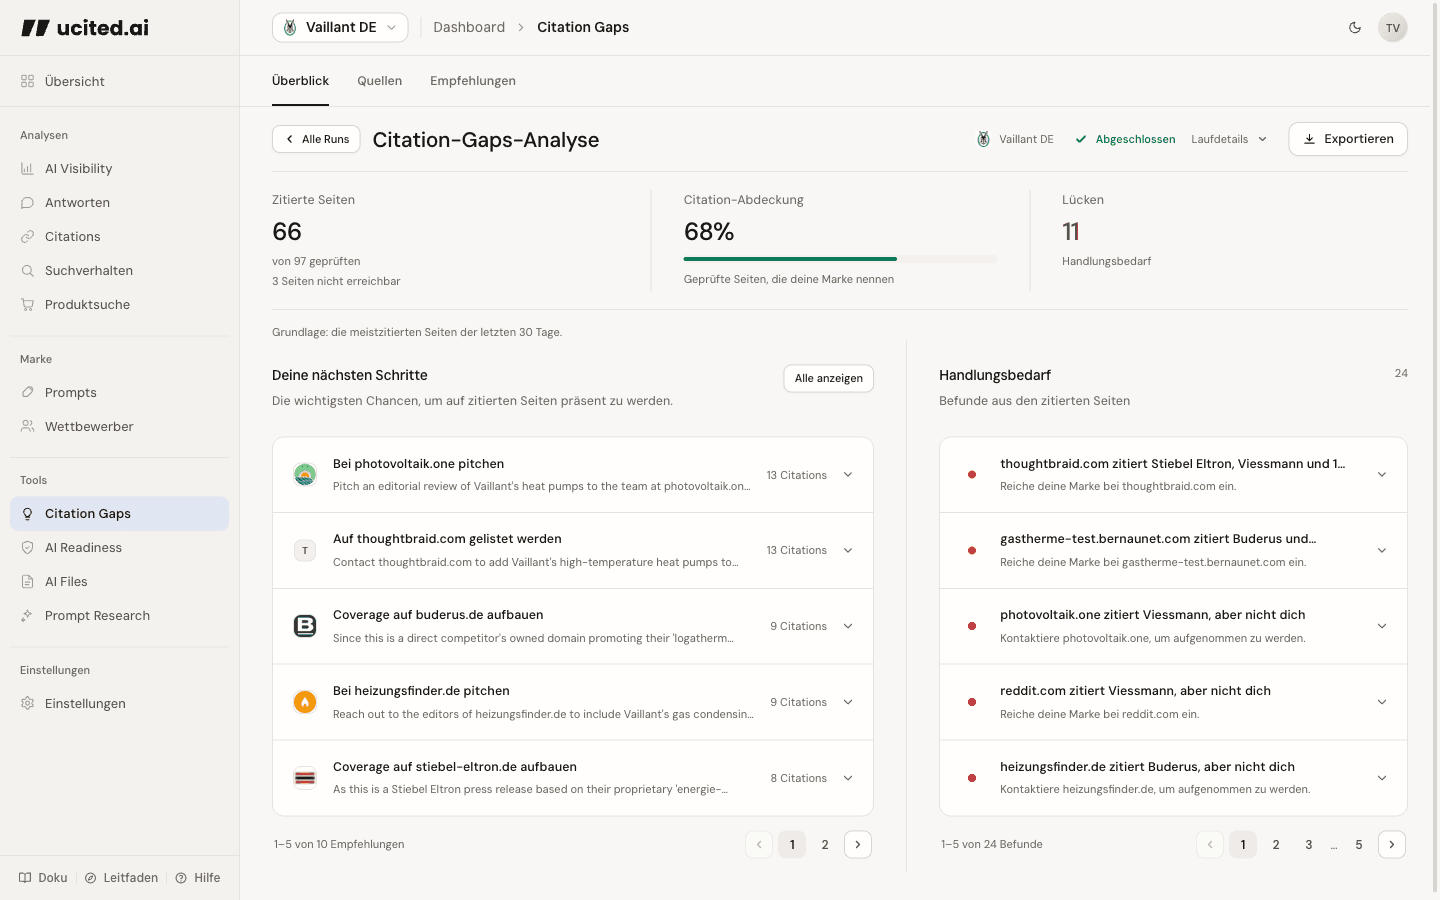
- Wettbewerber-Domains, die statt der eigenen zitiert werden, sind identifiziert
Wie misst man den Erfolg eines AI-Readiness-Audits?
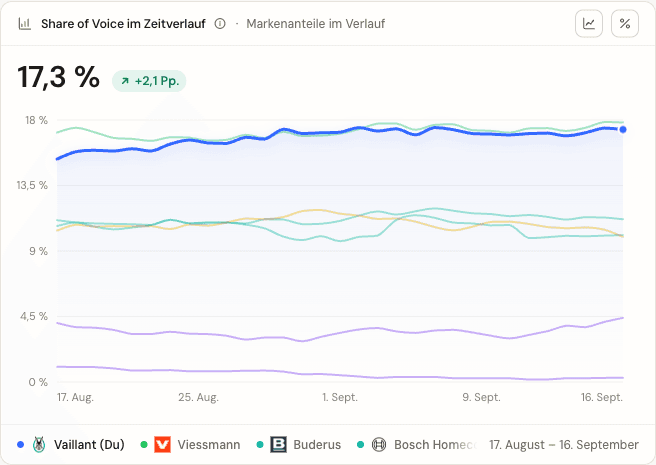
Der Erfolg eines AI-Readiness-Audits misst sich nicht an einem technischen Score, sondern daran, ob die Domain nach den Maßnahmen in LLM-Antworten zu den Zielfragen tatsächlich zitiert wird. Dafür werden dieselben Prompts wiederholt an mehrere KI-Systeme gestellt und die genannten Quellen protokolliert. Aus der Häufigkeit ergibt sich der Citation Share of Voice der eigenen Domain im Vergleich zu Wettbewerbern.
Ein Beispiel aus dem Zitations-Monitoring: Für die Frage „Welche Tools bieten einen AI-Readiness-Audit für Websites an?“ sind die am häufigsten zitierten Domains seitenreport.de, optimizegeo.ai, pagechecks.com und elitesiteoptimizer.ai (Auswertung der ucited-Zitationsdaten, Stand September 2026). Solche Daten zeigen, welche Quellen ein LLM aktuell bevorzugt und wo eine Sichtbarkeitslücke besteht.
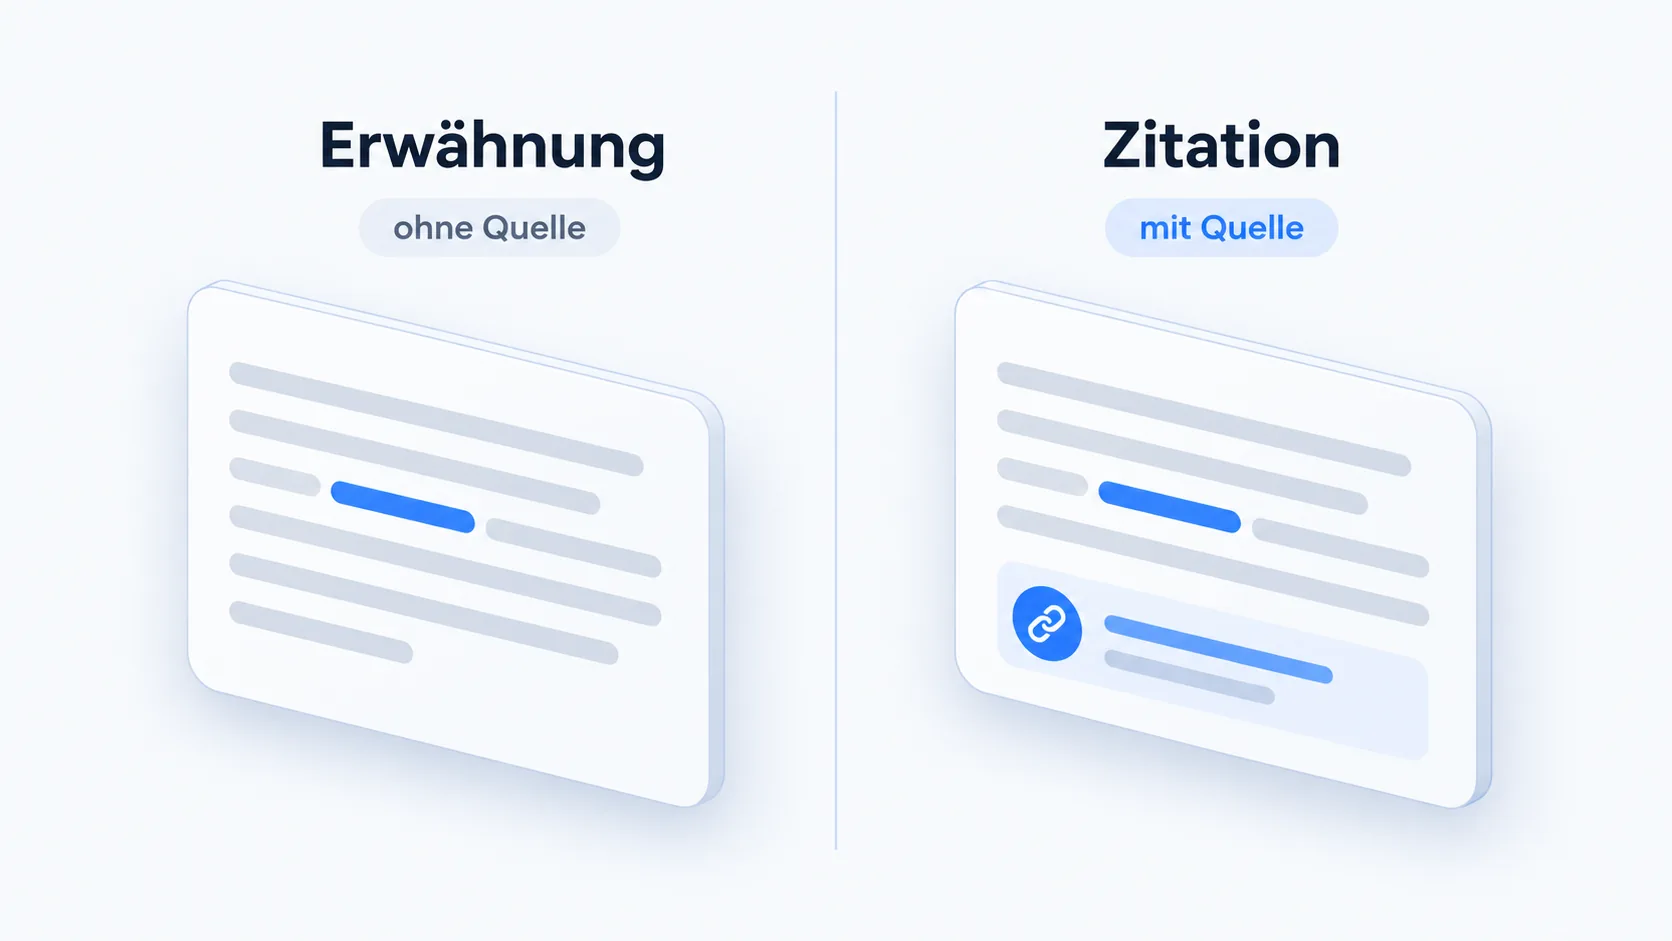
ucited unterscheidet bei der Interpretation methodisch sauber zwischen einer bloßen Erwähnung und einer tatsächlichen Quellen-Zitation und weist das Zitationsmerkmal nur dort aus, wo es semantisch belastbar ist.
Wie unterstützt ucited.ai beim AI-Readiness-Audit?
ucited.ai ist ein GEO-Analytics-Tool, das misst, ob und wie oft eine Website in den Antworten von ChatGPT, Perplexity, Google AI Overviews und weiteren KI-Systemen als Quelle zitiert wird. Es liefert damit den Nachweis-Teil eines AI-Readiness-Audits: Statt nur technische Voraussetzungen zu prüfen, zeigt es die tatsächliche Zitationslage je Prompt und je Modell.
Kernfunktionen im Kontext AI-Readiness:
- LLM-Citation-Monitoring: Wiederholte Abfrage definierter Prompts über mehrere KI-Systeme, Protokollierung der zitierten Quellen.
- Citation Share of Voice: Anteil der eigenen Domain an allen Zitationen zu einem Themencluster, im Vergleich zu Wettbewerbern.
- Quellenanalyse: Welche Domains werden statt der eigenen zitiert, und mit welchen Inhaltsformaten?
- AI-Readiness-Prüfung: Abgleich technischer und struktureller Voraussetzungen gegen die oben genannten Prüfpunkte.
ucited.ai ist ein SaaS-Tool und keine Agentur. Die Umsetzung der Maßnahmen erfolgt durch das eigene Team oder externe Partner; ucited.ai liefert Diagnose und Erfolgsmessung.
Häufige Fragen
Reicht es, GPTBot in der robots.txt freizugeben?
Nein. GPTBot ist der Trainings-Crawler von OpenAI. Für Zitationen in ChatGPT-Suchantworten ist OAI-SearchBot relevant. Andere Anbieter nutzen eigene User-Agents (ClaudeBot, PerplexityBot, Google-Extended). Ein Audit sollte alle für die Zielsysteme relevanten Crawler prüfen.
Ist ein hoher AI-Readiness-Score gleichbedeutend mit Zitationen?
Nein. Ein technischer Score bewertet Voraussetzungen, nicht das Ergebnis. Ob ein LLM eine Seite zitiert, hängt zusätzlich von der inhaltlichen Qualität, der Konkurrenz zu anderen Quellen und dem jeweiligen Modell ab. Der Nachweis erfolgt nur über Monitoring realer LLM-Antworten.
Wie oft sollte ein AI-Readiness-Audit wiederholt werden?
Die technischen Prüfpunkte (robots.txt, Rendering, Statuscodes) sollten bei jeder größeren Website-Änderung erneut geprüft werden. Die Zitationslage ändert sich kontinuierlich, weil KI-Systeme ihre Quellen laufend anpassen; hier ist ein fortlaufendes Monitoring sinnvoller als ein punktuelles Audit.
Unterscheidet sich AI-Readiness von klassischem technischem SEO?
Teilweise. Viele Grundlagen (Crawlbarkeit, saubere Struktur, valide strukturierte Daten) sind identisch. Spezifisch für AI-Readiness sind die Freigabe der KI-Crawler, die Optimierung auf Chunk-Ebene mit selbstenthaltenden Answer-Blocks und die Erfolgsmessung über Zitationen statt über Rankings.
Welche Inhaltsformate werden bei AI-Readiness-Fragen bevorzugt zitiert?
Aus der Quellenlandschaft zu diesem Thema dominieren Tool-Anbieter und offizielle Entwicklerdokumentation (developers.google.com, seitenreport.de, optimizegeo.ai, elitesiteoptimizer.ai; Auswertung der ucited-Zitationsdaten, Stand September 2026). Checklisten, Tool-Seiten und Primärdokumentation sind die Formate, die in diesem Umfeld bevorzugt zitiert werden.